AI推理成本高企,网络与存储成隐形瓶颈
行业背景:推理成本压力下的基础设施短板
随着AI应用规模化,Token调用量激增,推理成本已成为企业AI预算的主要部分。IDC数据显示,2026年AI推理成本在企业AI预算中占比超过80%。一座GW级AI数据中心四年总拥有成本(TCO)约550亿美元,其中网络和存储合计仅占基础设施TCO的16%-18%,却直接影响着超过80%的推理预算使用效率。这意味着网络与存储的规划失误,会被成倍放大到推理成本中。
核心信息:网络与存储决定Token产出效率
行业习惯以每美元FLOPS衡量AI基础设施,但实际Token产出成本在不同网络和存储架构下可相差数倍。以DeepSeek-R1推理为基准,新一代GPU平台每美元FLOPS提升约2倍,但每GPU的Token/秒从约90提升至约6,000(提升约65倍),每百万Token成本从约4.20美元降至约0.12美元(降低约35倍)。这一差距主要来自低精度计算、RDMA、投机解码、KV Cache卸载与复用、Prefill/Decode分离调度等基础设施层面的协同设计。
网络方面,在万卡集群中,采用动态路由优化的网络带宽利用率可达约95%,而传统以太网仅约60%。35个百分点的差距等效于数千万美元的GPU投资被闲置。网络效率的兑现需要速度、效率、架构、能效四个维度逐级递进:微秒级延迟与800G至1.6T带宽、动态路由与拥塞控制、Scale-Up/Out协同、以及CPO光电封装降低功耗。
存储方面,KV Cache作为推理过程中派生的、瞬态的、可重算的数据,传统存储的RAID、多副本等持久化机制对其而言是额外开销。新一代AI原生存储通过KV原生接口、分级保护、智能介质选择和DPU硬件卸载,实现“以存代算”。MLPerf基准测试显示,新一代AI原生存储推理吞吐量和能效较传统方案提升约5倍,首个Token生成响应时间(TTFT)在多厂商联合测试和VAST测试中分别改善约9倍和约20倍。
对产业链的影响:系统级协同成为关键
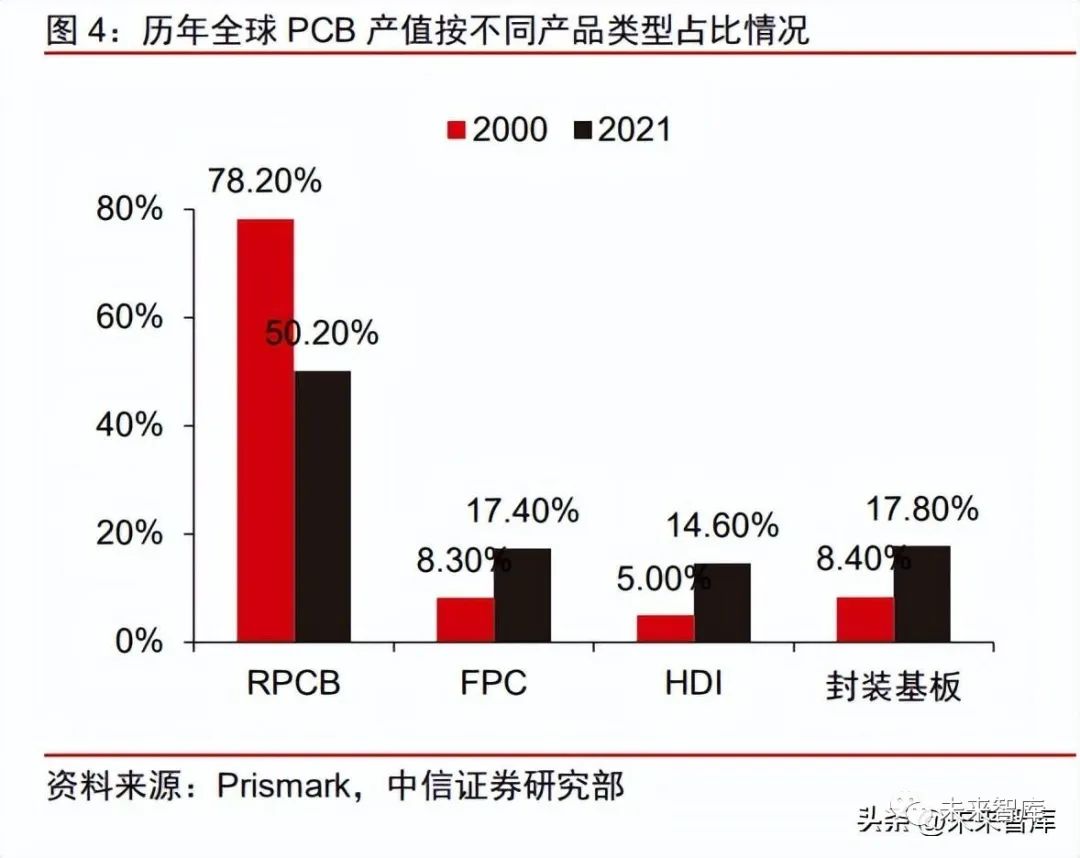
对于PCB与电子元器件行业而言,这一趋势意味着AI基础设施的竞争正从单一芯片性能转向系统级协同。网络与存储的升级将带动高速连接器、高密度互连(HDI)板、先进封装(如CPO光电封装)、高带宽内存(HBM)及配套电源管理器件需求。同时,AI原生存储对NVMe SSD的依赖,也将间接拉动存储控制器与相关PCB需求。产业链上游的材料、制造与封装环节需关注网络与存储架构变化带来的规格升级。
结语
AI工厂的效率天花板不在GPU本身,而在网络与存储的协同设计。用“每Token成本”替代“每美元FLOPS”作为评估指标,将网络投资与GPU同节奏规划,并把KV Cache视为独立数据类别,是降低推理成本的结构性路径。对于电子元器件与PCB供应链,这意味着更高频、更高密度、更低功耗的连接与封装方案将迎来持续需求。
来源:电子产品世界 EEPW